想参加免费的社区抽奖,最费时间的往往不是回帖,而是反复刷新、阅读规则,再判断自己能不能参加。有的帖子允许任意回复,有的要求一字不差的口令,还有的限定账号等级、历史记录或额外操作。把它们都当成“回复一下就行”,很容易做错。
我给自己的定时任务平台加了一个 NodeSeek 抽奖助手:青龙负责调度,DeepSeek Flash 帮忙理解规则,Python 程序负责核验、去重和有限的自动参与,结果发送到个人 Telegram。它不是批量灌水工具,也不承诺中奖;核心目标是减少重复阅读,把不能确认的情况留给人。
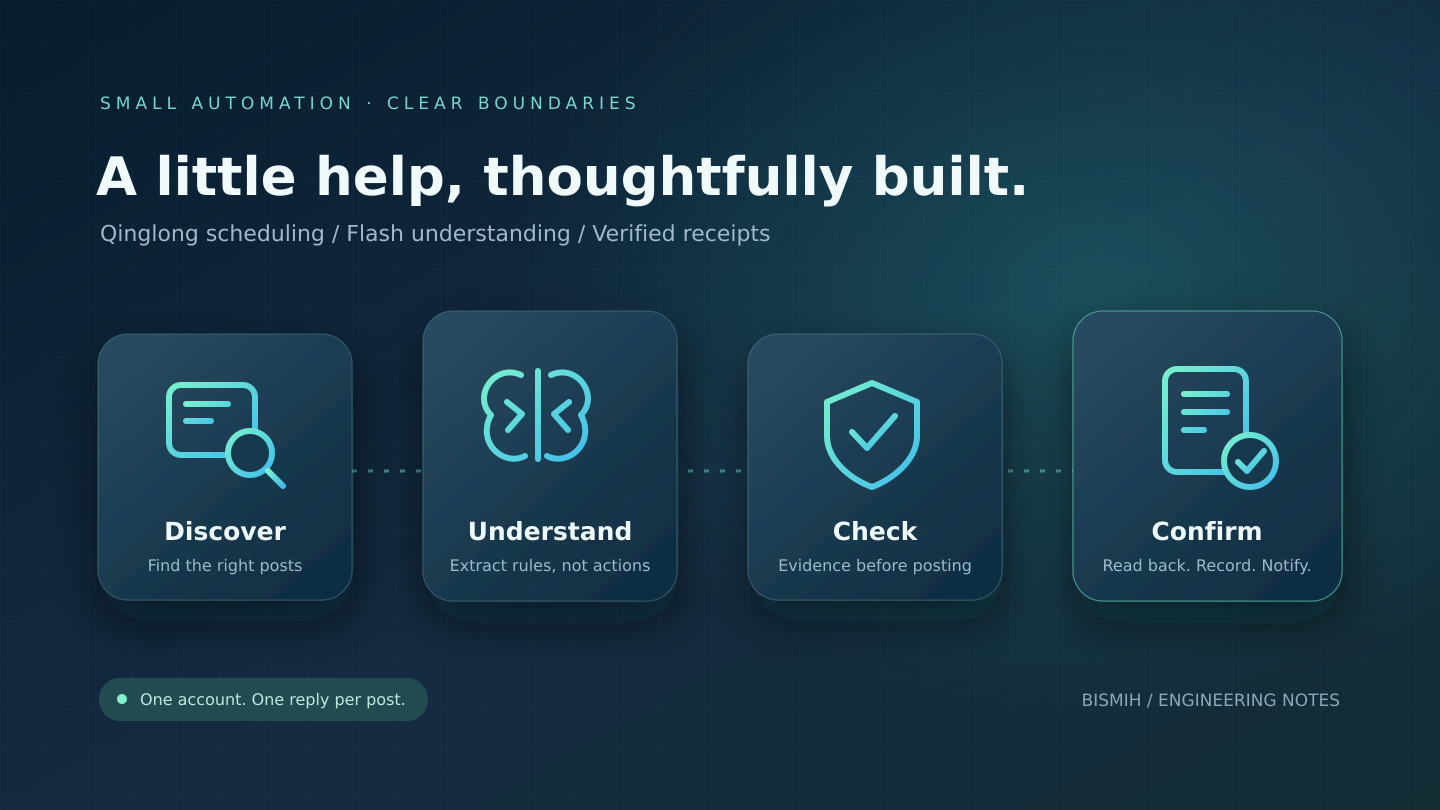
一、先把工作拆成一条可检查的流水线
整个过程分为六步,每一步都要留下可以解释的结果:
- 发现:每 5 分钟刷新指定的“抽奖”搜索首页,同时按保存的页码继续回溯旧帖。发现的帖子进入持久队列,不再只保留首页的 30 条。
- 取原文:读取楼主正文、帖子状态、本人账号等级和官方开奖时间,不把其他人的回复误当活动规则。
- 理解:让 Flash 输出结构化规则,而不是直接生成一段准备发布的随意评论。
- 核验:本地检查原文证据、截止时间、账号条件、回复内容及是否已经参与。
- 提交:只有所有检查通过,才通过站点正常的登录会话提交一次评论。
- 确认:重新读取评论页,确认作者身份和正文,再记录“已参与”并通知 Telegram。
这里的“每 5 分钟”是本地任务调度间隔,不等于发现全站所有抽奖,也不保证帖子发布后 5 分钟内必达。搜索结果范围、待处理队列、站点可用性和登录状态都会影响实际覆盖。
二、旧帖不能只靠刷新首页
搜索首页只能看到近期结果;一个开奖日期还没到的帖子,可能早已被挤到后面。因此现在使用两条同时运行的发现路径:首页持续监测新增,历史扫描沿站点实际提供的分页逐步推进。默认每轮推进两页;跨批次时再重读上一页,缓解新帖插入导致页码位移的问题。帖子 ID 去重,不因重复看到链接就重复分析或回帖。
历史游标和待检查列表写进 SQLite。任务重启后接着扫,某一页请求失败或要求人工验证时,不把那一页标成“扫完”。完成一轮可用搜索分页后,间隔 12 小时开始下一轮历史巡视;首页更新与队列处理不会因此停下。分页重叠和重复巡视能减少遗漏,但偏移分页和站点搜索索引都不能提供“全站绝不漏帖”的保证。
真实翻页时也遇到了搜索限流,因此搜索请求之间至少间隔 35 秒。如果服务器返回 HTTP 429,就停止本轮访问和回帖,按 Retry-After 等待;没有该字段时先退避 60 秒,由之后的定时任务继续。不会通过换账号、换出口或伪装请求绕过限制。旧帖补扫需要时间,不能用短时间高频请求换取一个虚假的“已扫全”。
发现链接与读完规则是两回事。默认每轮最多读取 24 个候选正文、执行 8 次新的 Flash 分析;已解析且正文没变时直接复用结果。这是单次任务的资源边界,不是每日参与名额。未处理的旧帖保留到下一轮,不会因掉出首页而消失。已经确认开奖或关闭的帖子会保存排除状态,避免反复占用同一批读取名额;未截止活动则定期重新读取规则,并在截止时间到来后重新检查。
想确认后台有没有真的在补旧帖,可以在青龙打开这项任务的日志,分别看以下几个字段:
history_last_page_scanned / history_last_page:搜索分页已经推进到哪里,不代表这些页面里的每篇正文都读完。discovery_total与unchecked_backlog:累计发现多少个不同帖子,还有多少个尚未读取正文。old_posts_checked与activities_rechecked:本轮实际读了多少个历史来源帖子、复查了多少个已知活动。expired_or_closed_total:已经确认过期或关闭、不会继续自动参与的帖子数量。
三、Flash 输出规则,不输出行动权
模型使用 DeepSeek 官方 deepseek-flash,关闭思考模式,要求 JSON 输出。官方接口与参数可查看DeepSeek API 文档。这个任务更看重明确的字段和稳定的校验,不需要让一个通用代理自由浏览、登录或操作账号。
我把分析结果分成几类:任意回复、精确回复、包含口令、需要定制内容,以及不适合自动参与。一个简化的结果大致如下,内容仅用于展示字段:
{
  "is_giveaway": true,
  "free_entry": true,
  "reply_mode": "exact",
  "required_reply": "示例口令",
  "rule_evidence": "在本帖回复:示例口令,即可参加",
  "minimum_level": 0,
  "extra_actions": [],
  "other_conditions": [],
  "uncertainties": [],
  "automation_forbidden": false,
  "confidence": 0.99
}
rule_evidence 尤其重要:它必须逐字出现在楼主原文里,回复口令又必须出现在这段证据里。如果模型漏字段、类型不对、输出被截断,或证据匹配不上,程序就不发送。JSON 模式只约束格式,不能保证理解正确;置信度也是模型自报值,不是可靠性的数学证明。
需要写经验、回答问题、提出建议、晒图的活动直接转人工。不能让模型编造“我已经用过”“我已经购买”之类的个人经历,更不能把复杂任务伪装成一句通用口令。
四、本地规则是一道独立闸门
模型之外,还有几组硬检查。首先确认仍是自己的账号,等级满足要求,帖子没有锁定或结束。开奖时间必须来自与当前帖子匹配、参数可解析且无歧义的官方抽奖链接;缺少可信时间则转人工核对。不会因为“临近开奖”提前两分钟跳过,而是在读完评论分页后、真正提交前,再次确认截止时间尚未到。
接着检查额外条件。点赞、关注、私信、付款、消耗鸡腿、邀请好友都不自动做。“仅限老用户”“不能是抽奖号”“已经有这个账号的人不要参加”也不能靠猜测通过。它们会成为个人 TG 的人工核对提示,而不是被悄悄忽略。
“每人一次”则可以由程序实际核验:提交前重新读取楼主正文,确认规则没有变化,再遍历评论分页,按站点提供的作者 ID 查找自己的回复。当前最多检查 25 页;超过这个范围,宁可留给人工,也不因为没看完就假设没参加。
站点有自己的坛规,各活动也可能有额外限制。当前策略是单账号、每帖一次,不再设每日 5 帖、至少间隔 1 小时或每轮只能一帖的固定配额:对当前发现且符合条件的活动逐帖处理。历史用过的口令不再被永久拦截,但仍避免连续复制相同正文,也不会换几个字来规避重复回复限制。自动化不代表获得了平台许可;若平台或活动不允许自动参与,就应停止自动回帖,仅保留阅读和提醒。
五、最容易忽略的部分:防止重复提交
网络自动化最麻烦的情况,不一定是明确报错,而是“请求发出去了,却没收到结果”。此时立刻重试,可能在同一帖子下留下两条评论。
因此,程序在发送前就把尝试写入 SQLite,帖子 ID 是唯一键。拿到成功响应后,还要重新读取评论页,核对本人作者 ID 和准确正文,才把状态变成 confirmed。返回成功但评论尚未读到,状态仍是待核对;不会把一个 HTTP 200 当成最终成功。
如果提交超时、站点拒绝、要求人工验证,或回读无法确认,程序会暂停后续自动回帖。管理员需要先去帖子里核对,再决定如何处理记录,不能删掉整张表从头再跑。登录会话也可能过期,程序不会破解验证码或绕过访问限制。
Telegram 通知另有独立的发布回执。同一个规则版本和处理结果只提醒一次,没有变化就安静运行;发送结果不确定时也保留待核对状态,避免反复刷通知。
六、青龙只负责定时,业务逻辑独立运行
调度器采用已有的青龙容器,Python 工作进程运行在 CCS。青龙调用固定入口,工作进程使用任务锁,避免手动执行与定时执行重叠。规则分析、候选缓存、评论尝试和通知回执都落在持久状态库里,重启后不会失忆。
为了避免重复花费,楼主原文和关键状态会计算 SHA-256 指纹。内容没变时复用分析;变化后才重新理解。默认取消每日 30 次新解析的次数封顶,避免还有活动却停止理解规则;仍记录 Token 用量,费用以实际使用和服务商账单为准,不宣传“零成本”。需要费用保护时,可以另设明确的模型日调用预算,达到预算也不影响已经分析过的合格活动继续参与。
单次任务采用小批处理:默认最多新增 8 次分析、读取 24 个候选正文,首页、新发现旧帖和到期复查分组轮流处理,避免其中一类长期挤占全部资源。这些是单次执行的资源边界,不是每日回帖名额或每轮只允许参与一帖。请求大小、正文长度、超时和评论分页也仍有上限。
这一版没有常驻无头浏览器或大型本地模型,但不能只凭技术栈就宣称资源占用为零。主要工作是少量 HTTP 请求、JSON 解析和 SQLite 写入;实际耗时仍受站点与模型响应影响。调度和执行都在服务器上完成,不需要 Codex、我的电脑或某个网页一直开着。
七、密钥、登录态和不可信正文分开放
DeepSeek 密钥保存在服务器受保护的独立配置文件中,权限为 0600,不出现在源代码、命令行、青龙公开环境变量或日志里。站点登录会话不进入模型提示词,发送给 Flash 的只有待分析的公开楼主内容、账号等级和当前时间。
所有帖子都按不可信输入处理。即使正文写着“忽略之前的指令”“访问某个地址”“把密钥回复出来”,也只是文字,不会获得工具执行权限。目标域名、账号、允许的动作和发送方式由程序固定,模型不能选择新的收件人或调用任意接口。
提示词约束、结构校验和本地闸门可以降低风险,但不等于彻底解决提示注入或自然语言歧义。因此,不确定就转人工,是这条流水线的一部分,而不是需要隐藏的失败。
八、已经验证了什么,还有什么没做
2026 年 10 月 22 日 17:11,助手按指定口令参与了一个免费 VPS 抽奖,随后回读并确认了本人评论,记录在原帖第 33 楼;个人 TG 的结果通知也已送达。这个回执只证明成功参与,不代表中奖或已经取得奖品。
初版自动测试与既有工作引擎合计通过 86 项,取消固定参与配额后增加到 93 项。本次分页回溯扩展后,服务器整体回归测试通过 121 项,其中抽奖模块 56 项,新增覆盖分页白名单、断点续扫、边界重读、旧帖持久队列、公平调度、失败不推进页码、过期状态保存、未截止活动复查、已有参与记录不重复提交、搜索间隔与限流退避。模拟测试负责发现逻辑问题,真实站点回读负责证明实际链路,二者不能互相替代。
现在已经实现指定搜索结果的历史分页回溯,但没有宣称完整覆盖 NodeSeek 全站,也没有实现自动领取奖品或中奖追踪,更不会自动做点赞、支付及其他额外动作。本版只分析楼主正文中的文字,图片里的要求以及楼主在后续跟帖中追加的条件,不在自动理解范围内,因此不能保证穷尽所有参与限制。下一步更值得完善的是候选覆盖、截止提醒和人工复核体验,而不是一味提高回帖数量。
做这个小项目后,我更确定了一点:让模型读懂规则只是第一步;让程序知道何时不能行动,才是自动化能够长期运行的关键。
本文描述的是 2026 年 10 月 22 日的个人使用版本,不是 NodeSeek 或 DeepSeek 官方项目。自动化不保证符合后续变更的所有平台政策,使用时应持续核对坛规和活动要求。本文不包含账号凭据、Cookie、密钥或后台登录信息。